先に答え:この本は何に使える?
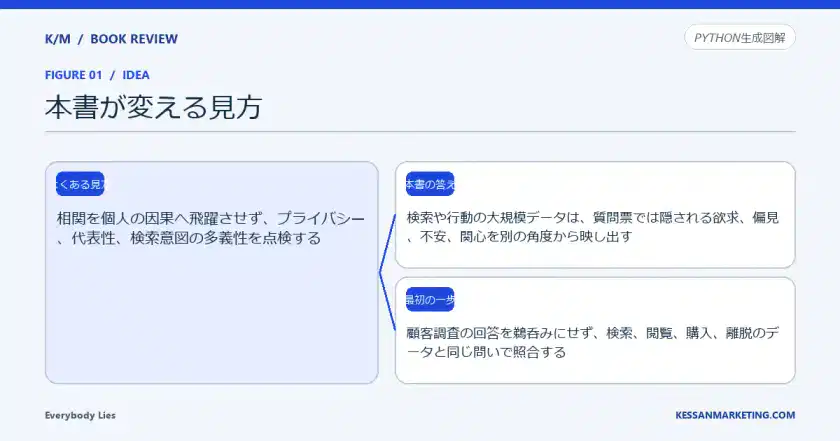
検索や行動の大規模データは、質問票では隠される欲求、偏見、不安、関心を別の角度から映し出す。この考え方を自分の課題に当てはめたいなら、『Everybody Lies』を読む意味がある。
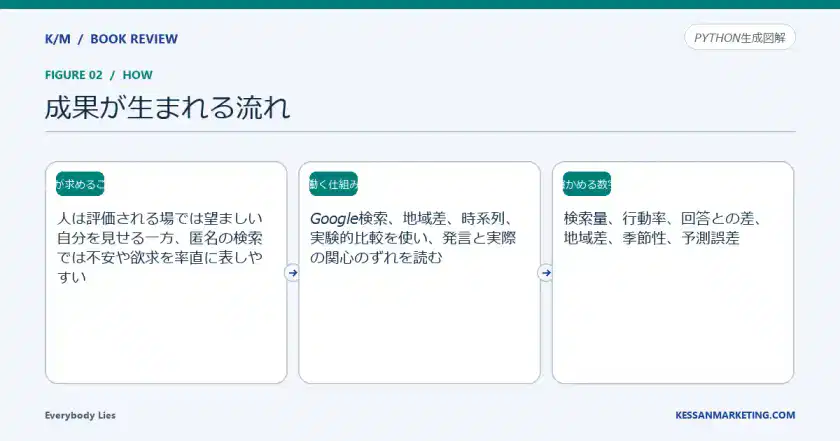
01検索や行動の大規模データは、質問票では隠される欲求、偏見、不安、関心を別の角度から映し出す
02Google検索、地域差、時系列、実験的比較を使い、発言と実際の関心のずれを読む
03人は評価される場では望ましい自分を見せる一方、匿名の検索では不安や欲求を率直に表しやすい
この本の考え方は、現実でも使えるか
『Everybody Lies 検索データが語る本音』が示す答えは、「検索や行動の大規模データは、質問票では隠される欲求、偏見、不安、関心を別の角度から映し出す」である。本書は、この考えをデータ・顧客理解の判断にどう使うかを説明する。
使いやすい条件
- データについて、知識の収集ではなく具体的な判断基準がほしい人
- 「Google検索、地域差、時系列、実験的比較を使い、発言と実際の関心のずれを読む」を自分の仕事や生活で試したい人
そのまま使わない方がよい条件
- データの全体像より、すぐ使えるチェックリストだけを短時間で探している人
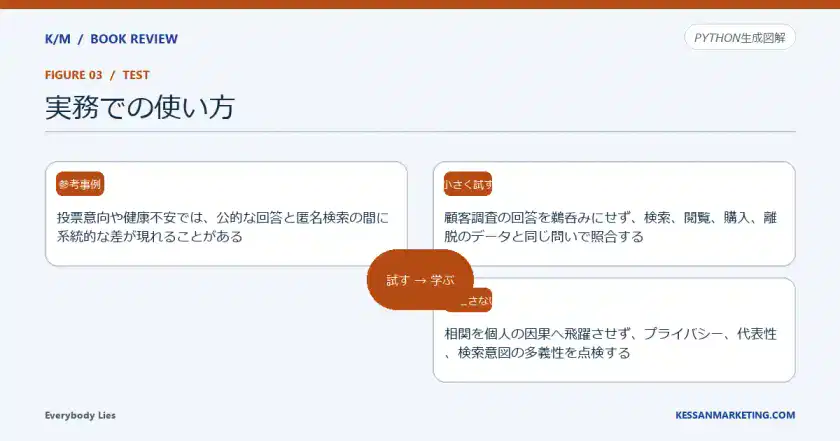
- 相関を個人の因果へ飛躍させず、プライバシー、代表性、検索意図の多義性を点検するを受け入れにくい人
最初に試すこと
顧客調査の回答を鵜呑みにせず、検索、閲覧、購入、離脱のデータと同じ問いで照合する
書籍情報
Seth Stephens-Davidowitz/Dey Street Books/2017/ISBN 9780062390851/English edition
本書は、何をどう説明しているか
本書の答えは、検索や行動の大規模データは、質問票では隠される欲求、偏見、不安、関心を別の角度から映し出すということです。背景にある仕組みは、Google検索、地域差、時系列、実験的比較を使い、発言と実際の関心のずれを読むこと。さらに、人は評価される場では望ましい自分を見せる一方、匿名の検索では不安や欲求を率直に表しやすいという人の気持ちまで読むと、表面の手法を真似せず、自分の仕事へ応用する条件が見えてきます。